Wie liest eine Texterkennung eine Rechnung?
Wie eine Texterkennung erst Textzeilen findet und sie dann Zeichen für Zeichen liest. Mit Modell, Testrechnung und Ergebnis am Beispiel von Quorvyn Docyra.
Zuletzt aktualisiert am · 4 Min. Lesezeit
Zwei Schritte statt einem
Eine moderne Texterkennung liest eine Seite nicht in einem Zug. Sie sucht zuerst, wo auf der Seite überhaupt Text steht, und liest danach jede gefundene Stelle für sich. Beide Schritte erledigt je ein eigenes neuronales Netz. Das hat einen praktischen Grund. Eine Rechnung besteht zum größten Teil aus weißer Fläche, und ein Netz, das nur einzelne Zeilen lesen muss, kann kleiner und genauer sein als eines, das die ganze Seite auf einmal verstehen soll.
Quorvyn Docyra verwendet dafür das Modell PP-OCRv6-small aus dem quelloffenen Projekt PaddleOCR in der Fassung, die PaddlePaddle selbst im ONNX-Format veröffentlicht. Das Netz für die Zeilensuche hat rund 2,5 Millionen Parameter, das Netz zum Lesen rund 5,2 Millionen. Zusammen sind die beiden Dateien etwa 30 MB groß. Sie werden mit der Anwendung installiert und laufen auf Ihrem Rechner, ohne dass ein Dokument das Gerät verlässt.
Zeilen finden
Für die Zeilensuche verkleinert Docyra die Seite so, dass ihre längere Seite höchstens 1600 Bildpunkte misst. Ein sehr kleines Bild wird vorher vergrößert. Das erste Netz gibt für jeden Bildpunkt an, wie wahrscheinlich er zu Text gehört. Das Verfahren dahinter heißt Differentiable Binarization. Aus den Bereichen, die eine Schwelle überschreiten, werden Rahmen um zusammenhängende Textstücke, meist eine Zeile oder ein einzelner Eintrag in einer Spalte. Rahmen, bei denen sich das Netz zu unsicher ist, fallen weg.
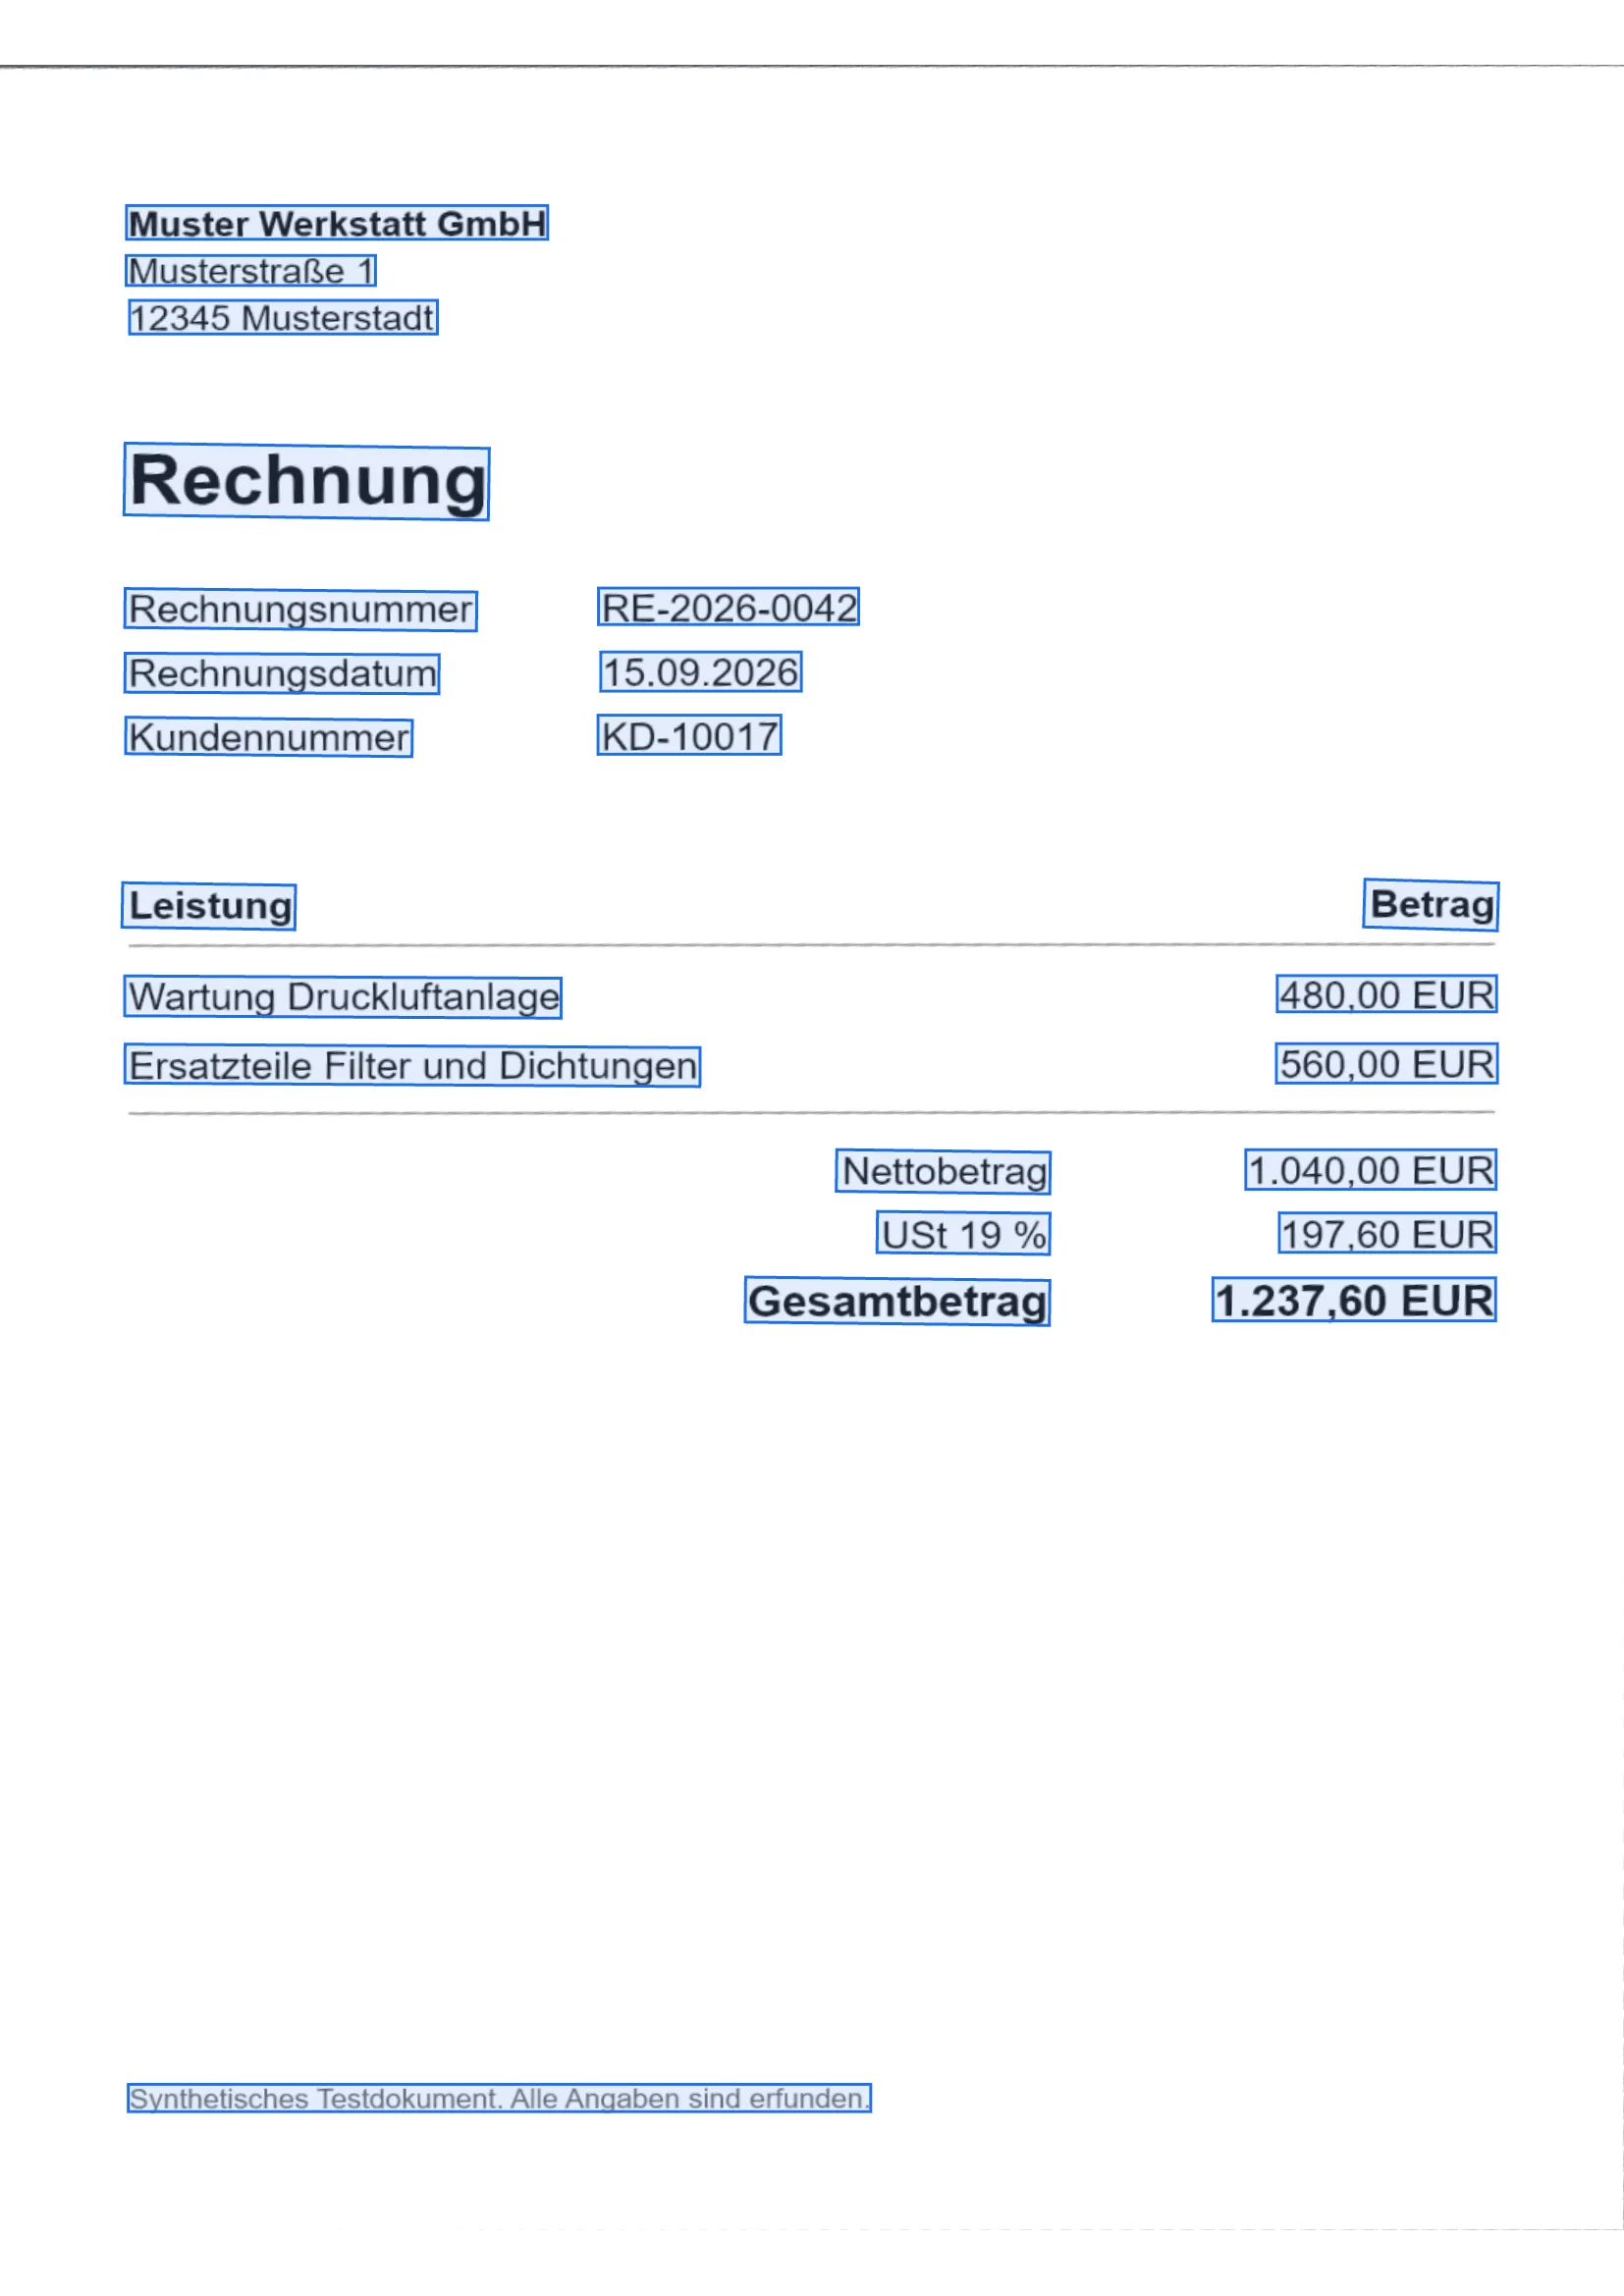
Die Abbildung zeigt, dass die Rahmen dem Aufbau der Rechnung folgen. Die Bezeichnung Rechnungsnummer und ihr Wert sind zwei getrennte Stellen, weil zwischen ihnen eine breite Lücke liegt. Das ist für die Suche gleichgültig, spielt aber eine Rolle, sobald Felder einander zugeordnet werden sollen.
Zeichen lesen
Jede gefundene Stelle wird aus der Seite ausgeschnitten, auf eine einheitliche Höhe gebracht und dem zweiten Netz gegeben. Es betrachtet den Ausschnitt von links nach rechts in schmalen Streifen und schätzt für jeden Streifen, welches Zeichen dort steht oder ob dort gerade keines steht. Sein Zeichenvorrat umfasst 18.708 Zeichen. Weil ein breites Zeichen über mehrere Streifen reicht, steht derselbe Buchstabe oft mehrmals hintereinander. Ein Dekodierschritt mit dem Namen CTC fasst solche Wiederholungen zusammen und entfernt die leeren Streifen. Was übrig bleibt, ist der gelesene Text der Stelle.
Zum Schluss sortiert Docyra die Stellen in Lesereihenfolge und legt den Text als Volltext zum Dokument. Darüber finden Sie es später in der Suche. Beim Export als PDF wird der erkannte Text als unsichtbare Ebene unter das Bild gelegt, sodass er sich im PDF markieren und kopieren lässt.
Was der Testlauf ergeben hat
Für die Abbildungen haben wir Docyra eine erfundene Rechnung lesen lassen, einmal als sauber gesetzte Seite und einmal als synthetisches Foto, das vorher entzerrt wurde, wie es der Artikel Wie wird ein schräg fotografiertes Dokument entzerrt? beschreibt. Anschließend hat der Test geprüft, ob die vier Sollwerte der Rechnung im erkannten Text vorkommen, wobei Leerzeichen und Groß- und Kleinschreibung nicht zählen.
| Feld | Erwartet | Gesetzte Seite | Entzerrtes Foto |
|---|---|---|---|
| Rechnungsnummer | RE-2026-0042 | RE-2026-0042 | RE-2026-0042 |
| Rechnungsdatum | 15.09.2026 | 15.09.2026 | 15.09.2026 |
| Kundennummer | KD-10017 | KD-10017 | KD-10017 |
| Gesamtbetrag | 1.237,60 EUR | 1.237,60 EUR | 1.237,60 EUR |
In beiden Fällen wurden alle vier Werte zeichengenau erkannt. Die Grundlage dafür ist ein synthetisches Testdokument, ein Durchlauf je Fassung, Docyra auf Commit b2bd60d. Den Abgleich mit den Sollwerten hat der Test vorgenommen und nicht die Anwendung.
Was das Ergebnis nicht belegt
Vier richtig gelesene Felder auf einer Seite sind ein Nachweis, dass die Kette aus Zeilensuche, Lesen und Entzerren auf einer klaren Vorlage zusammenarbeitet. Eine Genauigkeit lässt sich daraus nicht ableiten. Die Rechnung ist in einer gewöhnlichen Schrift gesetzt, schwarz auf weiß und ohne Störungen, und auch das Foto ist am Rechner entstanden und kennt keine Unschärfe, keine Schatten und kein Papierrauschen. Über echte Fotos, schlechte Kopien, ungewöhnliche Schriften oder Handschrift sagt der Lauf nichts.
PaddlePaddle gibt für PP-OCRv6-small eine gewichtete mittlere Erkennungsgenauigkeit von 81,3 Prozent an und für die kleinere Stufe tiny 73,5 Prozent. Das war der Grund, die größere Stufe zu wählen. Beide Werte stammen aus den Messungen von PaddlePaddle auf deren eigenen Testdaten. Wir haben sie nicht nachgemessen, und auf Ihre Dokumente lassen sie sich nicht übertragen.
Deshalb gilt, was auch auf der Produktseite steht. Ausgelesener Text ist Maschinenausgabe und kann falsch sein. Er macht ein Dokument auffindbar, als verbindliche Abschrift taugt er nicht, und maßgeblich bleibt das Original.
Wie es weitergeht
Die Texterkennung gehört in Quorvyn Docyra zu Docyra Pro. Einen allgemeinen Einstieg in das Thema gibt Wie funktioniert Texterkennung offline unter Windows?. Docyra befindet sich noch in Entwicklung und ist nicht erhältlich.
Weiterlesen
- EinstiegWie funktioniert Texterkennung offline unter Windows?
- EinstiegWie fotografiere ich ein Dokument, damit es gut lesbar wird?
- EinstiegWie digitalisiere ich Ausweis und Kontoauszug ohne Cloud?
- EinstiegWie ordne ich meine Unterlagen zu Hause digital?
- VertiefungWie wird ein schräg fotografiertes Dokument entzerrt?